cs.RO · WORLD MODEL & MANIPULATION

LaDi-WM: A Latent Diffusion-based World Model for Predictive Manipulation

在视觉基础模型的潜空间里做扩散预测,让「想象」反过来迭代精修机器人动作
Yuhang Huang, Jiazhao Zhang, Shilong Zou, Xinwang Liu, Ruizhen Hu, Kai Xu · National University of Defense Technology / Peking University / Shenzhen University

与其费力生成像素级的未来画面,LaDi-WM 直接在预训练 VFM 的 latent space 中用 diffusion 预测未来状态——潜码由 DINO(geometric features)与 SigLIP(semantic features)拼成,并用一个 interactive diffusion 过程让两者互相 cross-attention。基于这个世界模型,作者设计了一个 imagination-guided diffusion policy:策略先出一版动作,世界模型据此想象未来,再把想象喂回策略去精修,如此迭代。LIBERO-LONG 上比 behavior cloning 基线提升 27.9%,真机场景提升 20%。

arXiv:2505.11528v6 [cs.RO] · 12 Sep 2025 Benchmarks: LIBERO-LONG · CALVIN D-D · 真机 CR10 训练:单张 NVIDIA 4090 📄 arXiv:2505.11528 💻 Code (作者声明将开源)
world modellatent diffusiondiffusion policy机器人操作视觉基础模型imitation learningiterative refinementLIBERO预测式操作

01 Motivation

Predictive manipulation 的想法很直接:如果机器人能先「想象」出动作执行后的未来状态,就能把这份预判用于动作规划,对长程任务尤其有用。问题出在怎么想象。主流做法让 world model 去预测未来的视觉帧,但论文指出「pixel-level visual prediction often exhibits limited performance and generalizability」——重建像素既贵又难,扩散模型的开销更是雪上加霜。

另一条路线是预测潜在表征(Dreamer 系列、IRIS、TD-MPC2)。这确实简化了学习、泛化也更好,但论文点出其软肋:这些方法的 latent space「is typically optimized for image reconstruction, thus failing to capture the geometric and semantic information that is crucial for successful manipulations」——为重建而学的潜空间,未必编码了操作真正需要的几何与语义。DINO-WM 已经开始用预训练 DINO 特征引入几何信息,但只有几何还不够。

“We find that predicting the evolution of the latent space is easier to learn and more generalizable than directly predicting pixel-level images.”

于是本文的主张是:把世界模型建在预训练视觉基础模型(VFM)已经对齐好的潜空间上,同时容纳几何(DINO)与语义(SigLIP)两路信息,并显式建模这两路的动态关联。作者发现,用 latent diffusion 建模几何与语义的交互,会让两种表征更好地对齐,从而带来更快的收敛以及跨场景、跨任务的泛化能力。

LaDi-WM 方法与效果总览
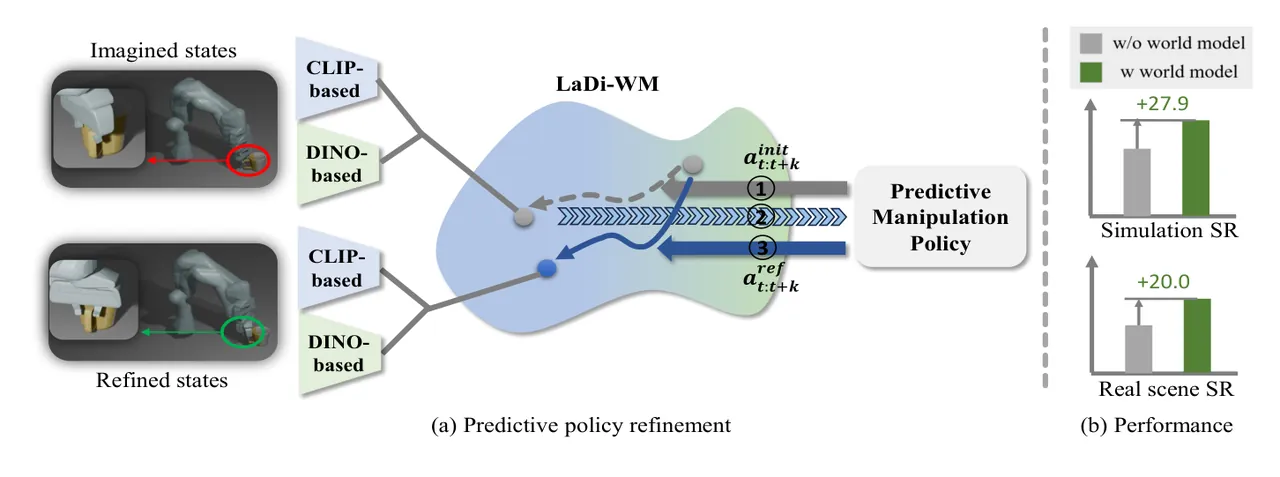
Figure 1. (a) 闭环三步:① 策略先给出一版初始动作序列,世界模型据此产生 imagined future states;② 这些想象状态作为额外输入回灌给策略;③ 得到精修后的动作。(b) 得益于世界模型,在仿真与真机上都取得显著提升。
+27.9%LIBERO-LONG 相对 BC 基线(40.8 → 68.7 Avg.SR)
+15.1%LIBERO-LONG 相对前 SOTA Seer(53.6 → 68.7)
+20.0%真机 Avg.SR 相对 Vanilla BC(40.0 → 60.0)
3.63CALVIN D-D Avg.Len.(前 SOTA Seer 3.60)

02 Method

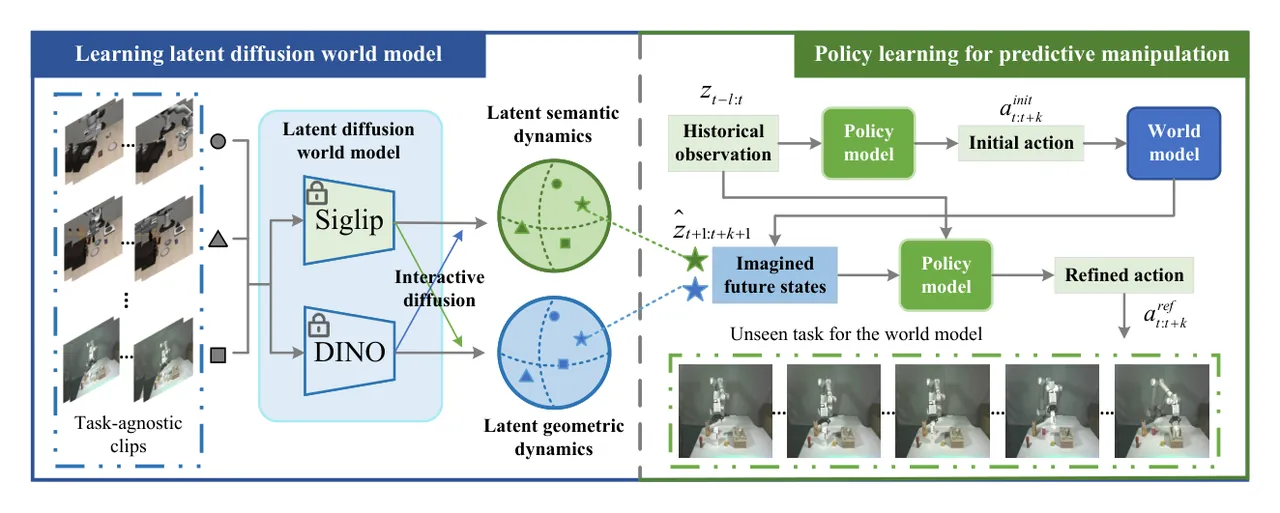
整套方法由两部分组成:latent diffusion-based world model(负责想象未来状态)与 imagination-guided policy(负责动作规划)。关键的工程选择是:世界模型在 task-agnostic clips 上训练——与策略训练所用的数据无关,这正是跨任务泛化的来源;训练好后冻结,只作为「想象器」为策略提供指导。

整体框架
Figure 2. 整体框架。先在 task-agnostic 片段上训练 LaDi-WM,这有利于 cross-task generalization;训练好的世界模型生成 imagined future states,作为有效的指导信号输入策略网络,显著提升操作性能。

潜空间:DINO 的几何 + SigLIP 的语义

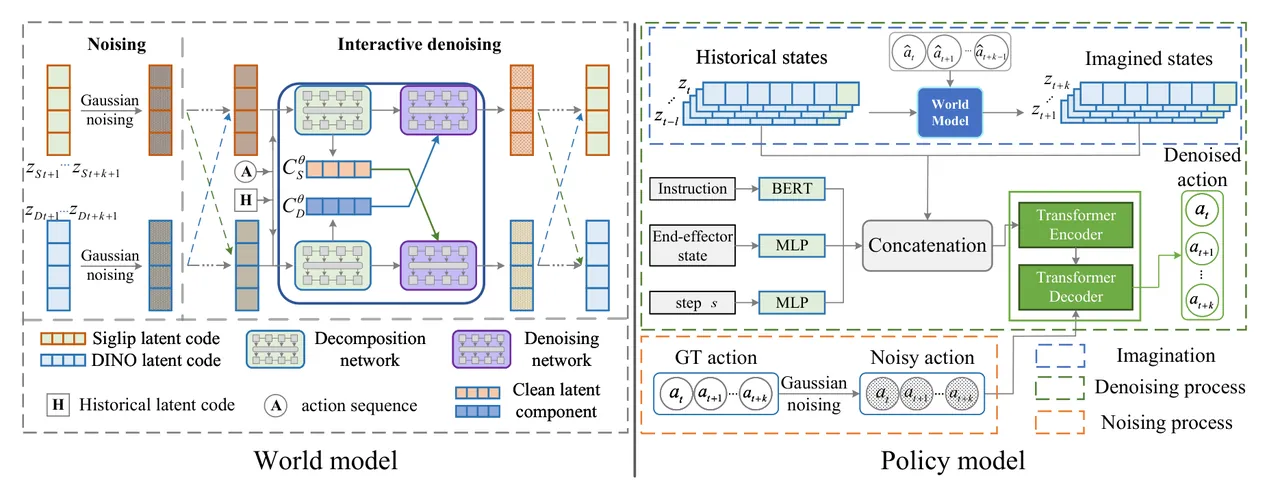
图像观测 It 被两个冻结的基础模型编码,拼接成潜状态:zt = [zDt; zSt] = [fdino(It); fsigl(It)],其中 DINO 提供 geometric latent code、SigLIP 提供 semantic latent code。世界模型的目标是给定历史潜状态 zt−l:t 与动作控制 at:t+k,采样出未来潜状态 zt+1:t+k+1 ~ pθ(· | zt−l:t, at:t+k)。注意这里全程不做像素重建——预测的对象就是潜码本身。

Interactive diffusion:让几何与语义在去噪时互相看见

为什么不能一个扩散过程通吃?论文的理由是「the two types of codes follow different distributions」,用同一个扩散过程学两种动态并不合适;但完全分开学,又会「overlook the relationships between high-level semantics and low-level geometry」。于是作者提出 interactive diffusion process:两路潜码各自加噪、各自去噪,但在去噪时交叉互为条件。

更精细的一点是:交互用的不是含噪潜码,而是从含噪潜码中分解出的 clean latent component。具体地,两个 decomposition network fθ1/fθ2 先从各自的含噪潜码估计出 clean component CDθ、CSθ(条件是各自的历史潜码与动作);随后 denoising network fθ3/fθ4 在恢复 DINO 潜码时把 CSθ 作为条件,恢复 SigLIP 潜码时把 CDθ 作为条件——即用「对方的干净成分」来引导「自己的去噪」。实现上是 diffusion transformer 架构:decomposition network 为 8 层 transformer、hidden dim 384,denoising network 用一层 cross-attention 让两类表征交互。训练用 MSE loss,同时监督预测的干净潜码、噪声与 clean component 四项。

世界模型与策略模型的详细结构
Figure 6. 世界模型(左)与策略模型(右)的详细结构。世界模型对 DINO 与 SigLIP 潜码分别加噪,去噪阶段通过 cross-attention 让两类表征交互;策略模型把多模态输入 tokenize 后送入 transformer encoder(6 层)融合,再由 decoder(4 层,hidden 256)在带噪动作上去噪得到动作。

Imagination-guided diffusion policy 与推理期迭代精修

策略是一个 transformer 架构的 diffusion policy,形式为 at:t+k = πθ(zt−l:t, et−l:t, ẑt+1:t+k+1, 𝒯),输入包括 l 帧历史潜状态、历史 end-effector 状态、世界模型想象出的 k 帧未来状态,以及任务指令 𝒯。选择 diffusion policy 的理由是它「has advantages in learning multimodal action distributions and addressing high-dimensional action spaces」。

推理阶段的核心机制是 iterative refinement:策略先产生初始动作序列 â,世界模型据此想象未来状态 ẑ,ẑ 再作为额外输入让策略重新预测——因为「the initial action may be suboptimal, the resulting imagined future states may lack sufficient precision」,所以要闭环迭代,让想象与动作互相收敛。作者在附录中解释了它为什么有效:diffusion policy 的输出不是确定值而是一个分布,迭代精修能「gradually reduce the entropy of the predicted distribution」,使预测更贴近 ground truth。

实现细节

  • 历史长度 l 固定为 4 帧;想象帧数在消融中讨论(6 帧时最好)
  • 原始图像分辨率 128 × 128,patch size 14 × 14
  • 动作空间 7 维:末端执行器的平移、旋转与开合增量
  • 策略用 ADM 扩散算法,2 步去噪即可收敛

训练开销

  • 世界模型:batch size 4,单张 NVIDIA 4090,约 3 天
  • 策略模型:同一设备,batch size 24,约 6 小时
  • 世界模型在 task-agnostic 数据上训练,策略训练时的动力学对它是 unseen

03 Experiments

仿真在两个公开 benchmark 上进行:LIBERO-LONG(10 个长程任务,主表中每个任务仅 10 条演示)与 CALVIN D-D(连续完成任务数 / Avg.Len.)。真机为 7-DOF CR10 机械臂、双相机、7 个自定义任务,用仿真预训练策略 + 每任务 10 条真实演示微调。基线包括 DreamerV3、TDMPC2、ATM、Seer 以及 vanilla BC。

LIBERO-LONG(每任务 10 条演示,Avg.SR ↑)

MethodTask1Task5Task7Task10Avg.SR ↑
DreamerV338.330.041.750.033.5
TDMPC245.031.736.751.737.0
ATM46.733.343.353.344.0
Seer(前 SOTA)71.766.751.750.053.6
Ours88.383.378.371.768.7

(表中仅摘录 10 个任务里的 4 列以便阅读,Avg.SR 为全部 10 个任务的平均,数字逐字取自论文 Tab. 1。需诚实指出:在 Task4 上 Ours 为 45.0,低于 Seer 的 51.7;Task3 上 Ours 63.3 亦仅略高于 ATM 的 60.0。)

论文表述:相较此前 SOTA,「our approach improves the average success rate by 15.1%」,并强调这是在世界模型从未见过策略训练所用动力学的前提下取得的。用全量数据训练时(附录 Tab. 6),本方法达到 90.7% Avg.SR,「representing a 3% absolute improvement over the previous state-of-the-art」。

CALVIN D-D(连续完成任务数,Avg.Len. ↑)

Method12345Avg.Len. ↑
Vanilla BC81.460.845.932.124.22.44
DreamerV382.063.146.634.125.12.51
ATM83.370.958.546.339.12.98
Seer92.282.671.560.653.53.60
Ours92.783.172.161.254.13.63

相较 vanilla BC,Avg.Len. 提升 1.19;相较 Seer 则只领先 0.03——CALVIN D-D 上的优势相当边际,真正拉开差距的是低数据量的 LIBERO-LONG。

Scalability

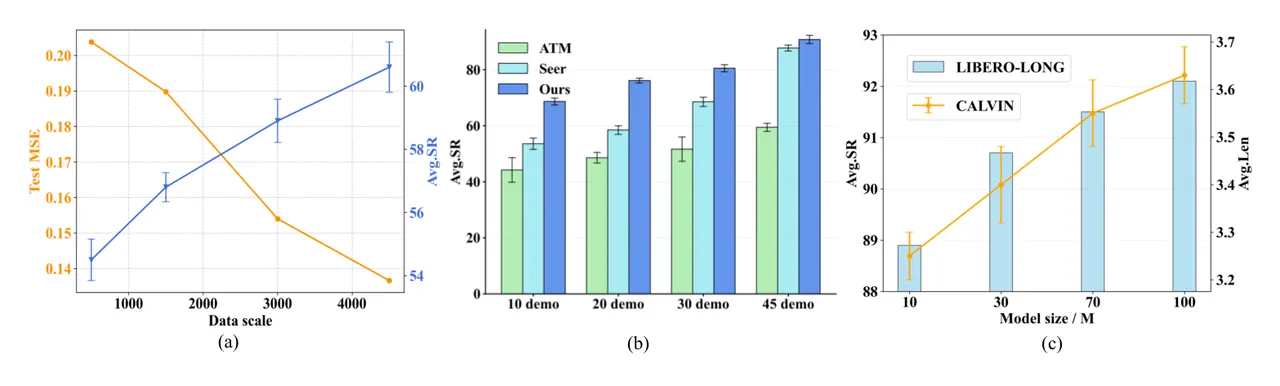
世界模型数据量、策略数据量与模型规模三条 scaling 曲线
Figure 3. 三个维度上的 scalability:(a) 扩大世界模型训练数据(500 → 4,500 demonstrations),test MSE 持续下降、策略性能同步提升;(b) 扩大策略训练数据(10 demos → 全量),成功率随之提升,且「consistently outperforms the previous SOTA across all data scales」,最终达到 90.7% Avg.SR;(c) 扩大策略模型规模,在 LIBERO-LONG 与 CALVIN 上都有可测收益。

真机实验(CR10,7 个任务,Avg.SR)

MethodTask1Task3Task5Task7Avg.SR
Vanilla BC35.015.055.055.040.0
Ours (without diffusion)35.025.065.070.049.3
Ours (pixel diffusion)40.025.065.070.051.4
Ours55.035.075.075.060.0

真机上相较 vanilla BC 提升 20%。这里的两条消融很关键:把扩散搬回像素空间(pixel diffusion)只有 51.4,去掉扩散只有 49.3——论文结论是「The latent design and the diffusion design enhance the Avg.SR by 8.6% and 10.7% respectively」,正好为「在潜空间做扩散」这一核心主张提供了真机侧证据。

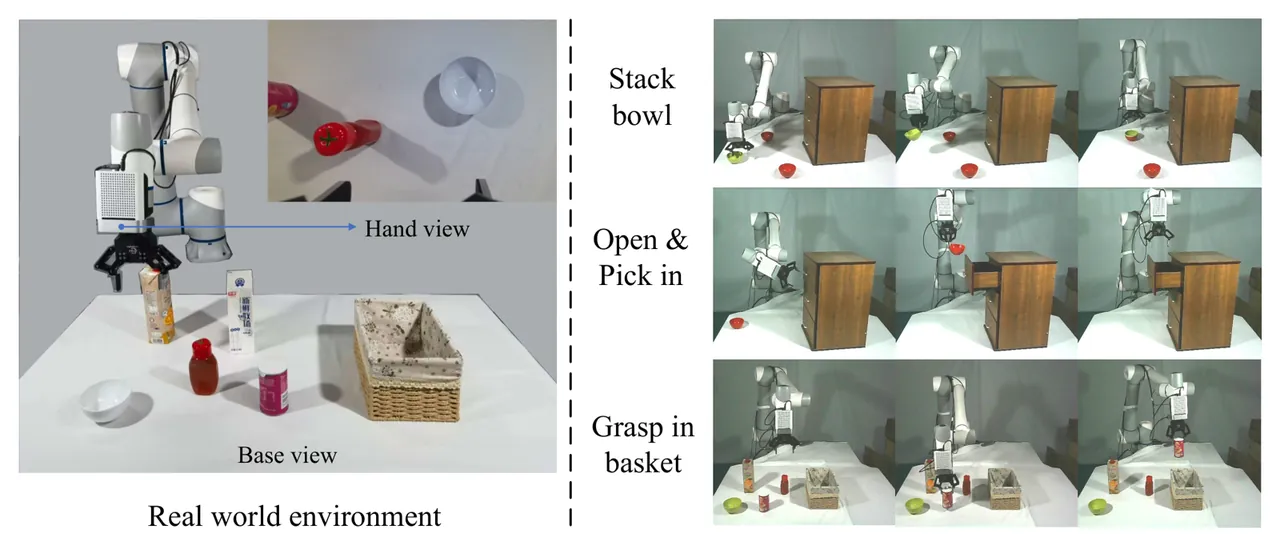
真机实验设置与执行示例
Figure 5. 真机实验:左为实验设置(7-DOF CR10 机械臂 + 双视角相机),右为若干执行示例。附录中作者提到,得益于世界模型的动力学建模能力,方法能应对复杂的光照变化。

Ablations

世界模型架构(LIBERO-LONG,每任务 10 条演示,1-time refinement 下评测,Tab. 3):without diffusion 52.1 → without clean interaction 56.7 → without siglip 57.3 → without interaction 58.9 → Ours 60.7。论文的三条读数是:比 transformer-only 架构高 7.8%;引入语义信息带来 3.4% 提升,「particularly for Task 1, Task 5, and Task 9, which involve objects with distinct semantic features」;interactive diffusion 比简单 concatenation 高 1.8%。

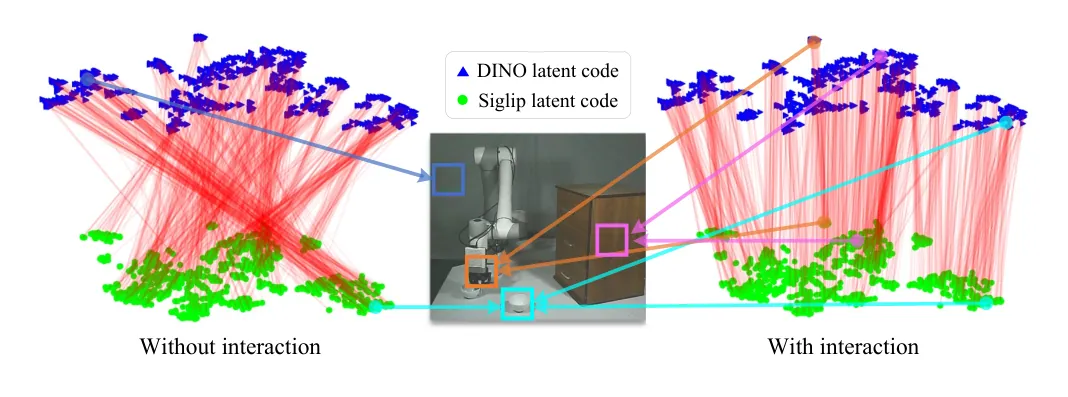
interactive diffusion 的潜码对齐可视化
Figure 4. Interactive diffusion 的可视分析:按 transformer 层的 attention weight 用红线连接最相关的特征。没有 interactive diffusion 时,潜码连向不同区域(左);有了 interactive diffusion,连接一致地落在同一物体上(右)——即两个潜分布被对齐了。

迭代次数(Tab. 4):without imagination 40.8 → 1-iter 60.7(+19.9)→ 2-iter 68.7(+27.9) → 3-iter 67.9(+27.1)→ 4-iter 68.2(+27.4)。结论是收益在 0→2 次迭代内几乎全部兑现,之后「performance plateaus beyond 2 iterations」,两轮想象已经够用。附录进一步用 PCA + KDE 画出动作分布,显示迭代次数增加时预测分布的熵逐渐降低;在 10/20/30 demo 三种数据规模下,2-iter 相对 1-iter 的提升在数据越少时越明显(10 demo: 59.9±7.23 → 68.1±4.38)。

其它:想象帧数增加时 Avg.SR 逐步提升、在 6 帧时达到峰值,作者的假设是「excessively long future imagination may become unreliable due to compounding errors」;策略输入用 joint states 比 EE states 高 9.0%(60.7 vs 51.7)。

04 Limitations

Note: 前两条为论文 §6 Limitations 明确陈述的内容;后两条标注为推断,由实验设置与设计本身读出,论文未如此表述。
训练样本规模有限(论文陈述)

「One limitation of our method lies in the limited scale of training samples. We plan to incorporate more training data from diverse environments and tasks.」——世界模型仅在 500–4,500 条演示的量级上训练,且 scalability 曲线显示还没饱和,说明当前性能受数据规模制约。

长程预测受累积误差限制,缺少记忆机制(论文陈述)

「longer-term future predictions can intuitively provide superior guidance for policy learning of long-horizon tasks, yet current world models face fundamental limitations in generating accurate extended predictions due to compounding error accumulation.」作者把「integration of memory mechanisms for maintaining long-horizon temporal consistency」列为未来方向。这与消融中想象帧数在 6 帧后不再变好的现象一致。
推理成本随迭代次数线性上升(推断)

每一轮 refinement 都要完整跑一次世界模型的扩散采样再跑一次策略去噪。论文报告了 2 次迭代的收益最佳,但全文未给出推理延迟或控制频率的数字,实机部署时的实时性代价无从判断。

对基础模型与观测形式的依赖(推断)

整个潜空间由冻结的 DINO 与 SigLIP 定义,128×128 的输入分辨率也偏低;方法的上限因此绑定在这两个 VFM 对场景的编码能力上。此外真机实验只在单一 CR10 平台、7 个任务上验证,跨机器人本体的迁移未作评估。