机器人 · 世界模型 · Gaussian Splatting

MRO-GWM:刚体的动作条件、物体中心 Gaussian 世界模型

Learning Action-Conditional and Object-Centric Gaussian Splatting World Models for Rigid Objects
Jens U. Kreber · Lukas Mack · Joerg Stueckler — Intelligent Perception in Technical Systems Group, University of Augsburg

把桌面场景表示成按物体分组的 2D Gaussian / anchor,用刚体变换把「历史物体位姿 + 未来末端执行器动作」直接编码进空间表示;再用一个带 spatio-temporal attention 的 transformer 预测未来各物体的 SE(3) 相对运动。学到的 world model 嵌入 iCEM 采样式 MPC,可在 ManiSkill 仿真中完成 push object to position 与 clear middle 两个 non-prehensile manipulation 任务。

ManiSkill 仿真 · YCB 物体 每场景 1–5 个紧密摆放的物体 训练/验证/测试物体池互不相交 📄 arXiv:2606.01950 🔗 Project page
object-centric Gaussian splattingaction-conditional world modelspatio-temporal transformermodel predictive controlnon-prehensile manipulationrigid body dynamics刚体位姿预测iCEMManiSkill

01 Motivation

World model 让 agent 能预判动作后果、从而提前规划。作者盯住的难点场景是日常家居桌面的 rigid-body dynamics:形状差异极大的许多物体紧挨着摆放,碰一个可能带动一片,而且因为遮挡,物体常常观测不全。

“A challenging domain are the rigid-body dynamics in everyday household scenes where many objects of highly varying shapes are closely placed next to each other. An interaction with one object might have effect on surrounding ones and the objects might not be fully observable due to occlusions.”

已有路线各有短板,作者在 Related Work 中逐条点名:

MRO-GWM 的定位因此是:多物体 + 动作条件 + 多步 + 部分观测,且遮挡靠 transformer 的空间聚合隐式建模(“We use a transformer model with spatial aggregation, spatial and temporal attention layers which implicitly models unobserved parts.”)。

三点贡献(原文自述):(1) 用 object-centric Gaussian splatting 作场景表示、用 per-object rigid transforms 编码位姿历史;(2) 提出在该表示上运行的 transformer,含 temporal / spatial block 与新的 spatio-temporal attention layer;(3) 把该 world model 集成进 MPC 做 non-prehensile manipulation。

0.45 cmmedian position error(主模型,moving chunks)
5.54°median rotation error(同上)
0.77SR — task 1 push object to position
0.82SR per object — task 2 clear middle

02 Method

输入是多视角 posed RGB-D 图像 I、相机位姿 ξcam、物体分割掩码 O,以及交互过程中每一步的物体位姿 ξobj 与末端执行器位姿 ξrobot(实验中掩码与位姿都取仿真器 ground truth)。给定物体位姿历史 τobj1:h、末端执行器历史,以及一段未来末端执行器位姿轨迹 τeeh+1:h+p,模型预测未来物体 SE(3) 位姿 τobjh+1:h+p。
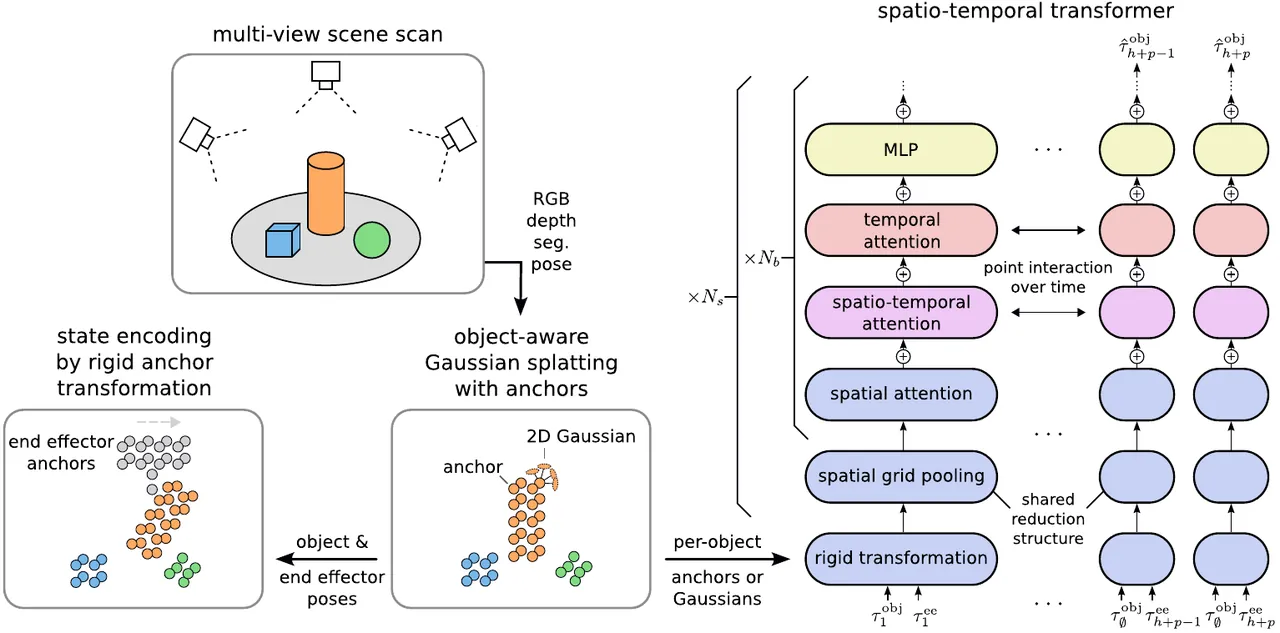
MRO-GWM 方法总览
Method overview(原文 Fig. 1)。左:多视角扫描 → object-aware Gaussian splatting 得到 per-object anchors / Gaussians;再按物体与末端执行器位姿做刚体变换,从而把场景状态历史“编码进空间”。右:spatio-temporal transformer —— spatial grid pooling 与 spatial attention block,叠加跨时间的 point 间 temporal attention 以及新提出的 spatio-temporal attention layer。给定历史与未来末端执行器位姿,输出未来物体位姿;τobj∅ 是未来步上物体位置占位用的 fixed dummy pose。

1 · 场景表示:object-aware Gaussian splatting + anchors

沿用 ObjectGS(ScaffoldGS 的物体感知扩展):场景不是直接优化 3D Gaussian,而是用一格格带 latent feature 的体素“anchor”,每个 anchor 用 MLP 解码出固定数量的 Gaussian。ObjectGS 给每个 anchor 一个唯一 object id(object id 也参与渲染并与分割掩码求 loss),于是 anchor 与它解码出的 Gaussian 都能唯一归属到某个物体——这正是做刚体级场景变换的前提。

作者在此之上做了三处改动:

模型支持两种输入:直接用 2D Gaussian 属性(position / rotation / scale / opacity),或用神经压缩后的 anchor。因为动力学建模要求表示与视角无关,ScaffoldGS 的 view-dependent 解码被弃用,只保留 view-independent 部分。

2 · 把「历史 + 动作」编码成 h+p 份变换后的场景

每个历史时刻,按各物体/末端执行器的位姿刚体变换其全部 anchor 或 Gaussian;每个预测时刻,只按输入动作变换末端执行器表示,物体表示保持不动。于是得到 h+p 份空间上不同的场景表示,模型沿时间轴与空间轴在其上运算。这就是「动作条件」的落地方式——动作不是拼进 feature 的向量,而是末端执行器点云在空间中的实际位移。

细节:anchor 变换的是其空间位置;anchor 本身没有朝向,作者用四元数编码其旋转作为附加特征,并把旋转后的 Gaussian offsets 与 scaling、latent feature 拼接。2D Gaussian 变体则直接施加空间变换,用 rotation / opacity / scaling 作特征。两者都会额外嵌入物体索引与一个布尔位(历史 or 未来)。为控规模,背景 anchor 中距离任何物体/末端执行器 anchor 超过 10 cm 的被过滤掉(“interactions can only occur around objects”)。

3 · Spatio-temporal transformer:三种 attention 的分工

骨架借 PTv2 的点云组件(k-NN 上的 spatial vector attention、按递增网格尺寸的 pooling)与 DiT 的残差块结构(layer norm 前置、AdaLN 式调制但用常数 conditioning、DiT 式 final layer 与初始化)。每个 stage 形如 si = bi,N ∘ … ∘ bi,1 ∘ pe ∘ pooli,并且同时处理所有时间步。

关键技巧在 pooling:按物体独立池化(背景也算一个),而且由于各时间步之间的空间结构只差一个刚体变换,作者只在第一个时间步为所有网格尺寸算一次“谁和谁池化到一起”,然后对所有时间步复用同一套 per-object pooling。好处有二:省算力;更重要的是,即使到了点数很少的高层 stage,每个点在所有时间步都有对应点——这正是跨时间 attention 得以定义的结构基础。池化后加上编码时间索引的 sinusoidal positional embedding。

每个残差块含四种层,堆叠顺序为 spatial attn. → temporal-spatial attn. → temporal attn. → MLP:

spatial attention(PTv2)

同一时刻内,点与其空间近邻交换信息,attention 计入空间相对关系。信息不跨时间轴流动。负责物体形状与物体间接触。

temporal attention(标准 Transformer)

每个点只与自己在其它时间步的对应点交换信息,不跨空间轴。负责单点的时间演化。

spatio-temporal attention(本文新增)

沿用 PTv2 的 attention 机制,但把邻居定义为该点在其它时间步的对应点。原文:“This directly provides information about the relative motion of each point for the attention calculation.”

输出头

最后一个 stage 的网格尺寸覆盖整个场景;因为按物体聚合,每个物体只剩一个点。丢弃背景与末端执行器的点,用一个 linear layer 把各物体点的特征映射为预测。

4 · 预测目标与损失

模型预测的是预测区间内相邻时间步之间、世界坐标系下的相对位置与朝向变化;从最后一个历史时刻积分即得位姿轨迹。旋转按 hitchhikerrotations 的建议用 9D rotation matrix 表示并对预测做正交化。由于相对旋转通常很小,作者做了归一化:R̃ = (R − I) ÷ Σrot(逐元素除以训练集上 R − I 的逐元素标准差),网络回归 R̃、用 l2 norm 算 loss,推理时反归一化再正交化。相对位置则除以训练集上的平均模长,与预测算 squared l2 norm。

5 · 规划:把 world model 塞进 iCEM MPC

作者实现了 iCEM 的一个变体,优化关键点参数化的末端执行器轨迹。每次规划迭代从 CEM 分布采样关键点序列,线性插值到固定 20 步的稠密末端执行器位置(步距由模型步频 5 Hz 与训练数据同款的恒定 5 cm/s 末端速度决定,超出最后一个关键点的位置就停在该点),送入 world model rollout,用任务相关 cost 打分,取 elite set 更新均值、返回 cost 最低的序列。规划频率 2 Hz,且每次只做一次优化迭代、只更新均值不更新协方差——原文理由是保持恒定探索、防止 CEM 分布坍缩。若更新后首个关键点已在机器人可执行范围内,关键点均值按序列索引平移一位(受 iCEM 的 action-sequence shift 启发,但作用在更粗的关键点尺度上)。
03 Experiments

全部实验在 ManiSkill 仿真中进行。桌面场景放 1–5 个 YCB 物体,用专门的采样流程让它们紧挨着、在机器人操作时容易互相影响。机器人是带棒状末端执行器的 Franka Panda,用 3D 末端位置控制器做 IK;与仿真器交互频率 20 Hz,仿真本身跑 100 Hz(ManiSkill 默认)。

数据集与协议

没有直接可比的 baseline。这是原文明确说明的:“Since there is no other work available that allows for direct comparison in our setting of multi-object dynamics with partial observations.” 最接近的 CompNeRFDyn 没有开源代码;多物体动力学方法 Neural Gaussian Force Fields 不支持以末端执行器位置动作为条件。因此下表全部是本文模型的变体与 ablation 之间的比较,不含外部方法对比。

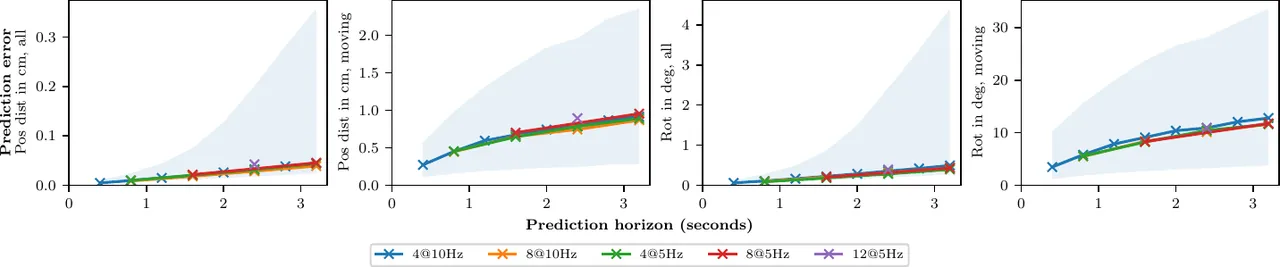
预测精度随时间的变化

不同模型变体的预测误差随预测时长的变化
原文 Fig. 2。横轴是预测时长(秒),四张子图分别是「位置误差(全部)/ 位置误差(仅有真实运动)/ 旋转误差(全部)/ 旋转误差(仅有真实运动)」。曲线为 5 个训练种子下各变体的中位误差,浅色带是 4@10Hz 变体的 25%–75% 分位区间。判定“有运动”的阈值是单步位置变化 > 1e-4 m、旋转变化 > 1e-2 rad。结论:决定中位误差的是预测的时间跨度,而不是步长粒度或步数——“for the same horizon all variants perform relatively similarly”。

「全部」与「仅有运动」两组图差距巨大、分位带很宽,作者解释了这数据本身的性质:即使某个物体被碰到,其它物体可能纹丝不动;而且末端执行器的微小差别可能造成天壤之别——“if it narrowly passes an object, the changes are zero, but if it hits the object, it might fall over and experience a rotation change in the order of magnitude of 90° and several cm of position change in under a second.”

变体与消融(原文 Table 1)

下表仅在 moving chunks 上统计;base model 为 YCB-100-100,所有模型 prediction horizon 4 @ 10 Hz;数值为 5 个训练种子的均值,括号内为标准差。

VariantMedian pos err (cm)Mean pos err (cm)Median rot err (deg)Mean rot err (deg)
Train set YCB-100-100 (main)0.45 (0.01)0.73 (0.01)5.54 (0.27)7.08 (0.05)
Train set YCB-50-2000.46 (0.01)0.75 (0.01)6.25 (0.30)7.14 (0.09)
Train set YCB-200-500.47 (0.01)0.75 (0.02)5.86 (0.36)7.14 (0.09)
Train set YCBV-100-1000.52 (0.04)0.83 (0.06)5.75 (0.35)7.84 (0.13)
Anchor size 0.0050.47 (0.02)0.75 (0.02)5.56 (0.09)7.15 (0.07)
Anchor size 0.020.48 (0.02)0.76 (0.01)5.87 (0.44)7.20 (0.10)
Explicit Gaussians0.48 (0.02)0.76 (0.02)5.80 (0.22)7.11 (0.08)
Limited view0.47 (0.01)0.75 (0.02)5.98 (0.22)7.27 (0.05)
No spatio-temporal attn.0.49 (0.01)0.77 (0.01)5.94 (0.18)7.27 (0.09)
No multiscale downsampling0.57 (0.01)0.86 (0.02)6.95 (0.25)8.03 (0.12)

要点(按原文口径):

定性预测

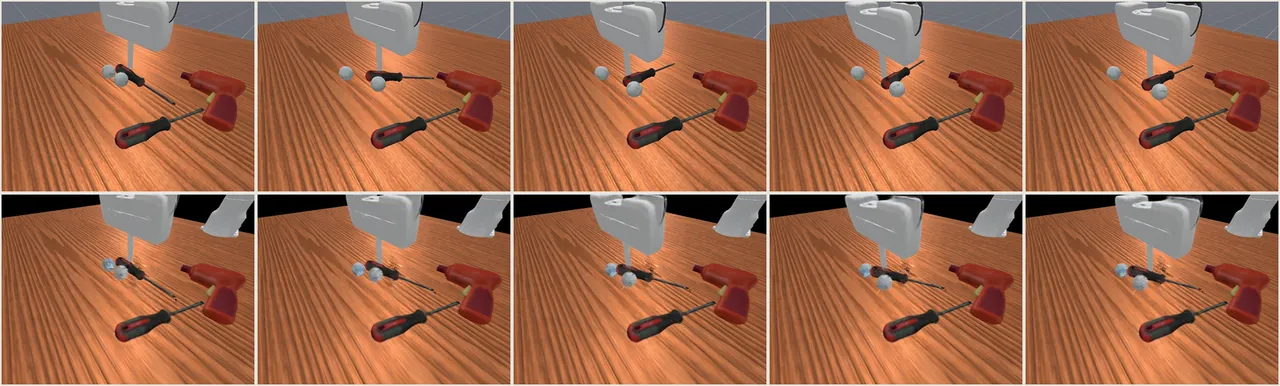
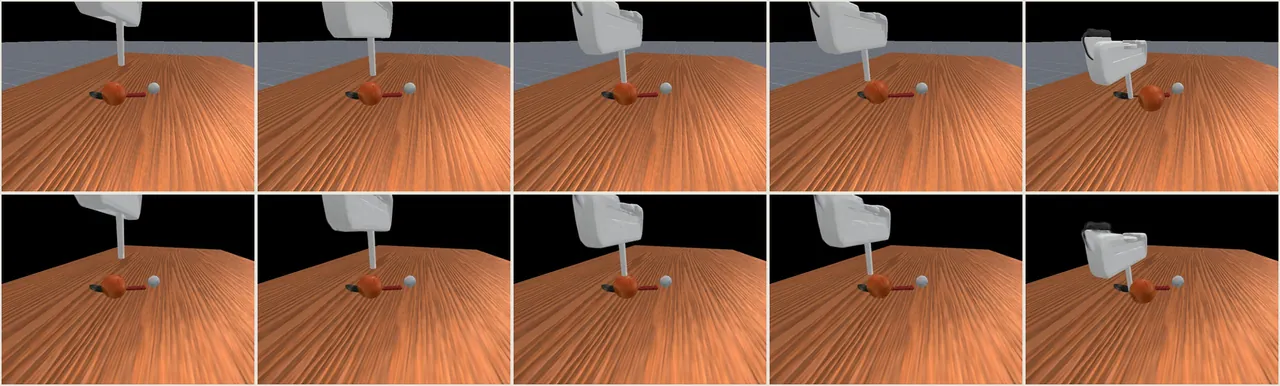
预测最准的样例:上排 ground truth,下排模型预测
原文 Fig. 3 中误差排名最小的样例。预测时长 2.4 秒(3 次模型调用)。上排为在仿真中回放的 ground truth;下排为模型预测——展示的是按预测位姿做刚体变换后 splat 出的 Gaussian 表示,即“模型眼中的场景”。样例是从位姿变化量排名前 10% 的 chunk 中按误差排名挑出的。这里模型对单个圆形物体的运动预测紧跟 ground truth。
预测最差的样例:上排 ground truth,下排模型预测
同一组图中误差排名最差的样例(同样取自 top 10% 运动量的 chunk)。原文描述:“The worst example shows a difficult multi-object interaction setting where a small change in end-effector position can result in a large change in object motion.” 另外在中位样例中,螺丝刀的旋转被低估;作者指出接触点靠近质心时这类运动本就难预测。

规划结果(原文 Table 2)

使用 prediction horizon 8 @ 5 Hz 的模型。两个任务在 40 个规划场景 × 每场景 5 个 episode 上评测,每个 episode 跑 1200 个环境步(= 1 分钟)。指标先在单个训练种子的所有 episode 上取均值,再对 5 个训练种子取均值(括号内为标准差)。final goal dist. 在成功或超时时测量。

tasktime to succ. (s)success rate (SR)SR@2cmSR AUCfinal goal dist. (cm)initial goal dist. (cm)
1. push object to position20.9 (0.6)0.77 (0.02)0.80 (0.03)0.83 (0.03)2.87 (0.38)14.17
2. clear middle (all obj.)26.7 (1.1)0.66 (0.05)0.72 (0.05)0.68 (0.04)3.12 (0.42)30.4
    clear middle (per obj.)—0.82 (0.03)0.88 (0.02)0.81 (0.02)——

任务定义与阈值:task 1「push object to position」随机选一个物体、在两轴各 [−15 cm, 15 cm] 内随机采一个 2D 目标位置,物体中心到目标的欧氏距离 < 1 cm 记成功(对其它物体的移动无约束);SR AUC 是阈值从 1 cm 到 5 cm、步长 5 mm 的平均成功率。task 2「clear middle」要把所有物体推出 y 轴上 [−15 cm, 15 cm] 的中央条带,成功判据是所有物体到边界距离为零;其 AUC 阈值范围为 0–5 cm、步长 5 mm。

可以看到:单物体的 task 1 成功率(0.77 @ 1 cm)高于要推动多达 5 个物体的 task 2(0.66 @ 0 cm);task 2 若按物体单独计成功则升到 0.82,放宽到 2 cm 阈值则为 0.88。两个任务的目标距离都从初值显著下降(14.17→2.87 cm,30.4→3.12 cm)。

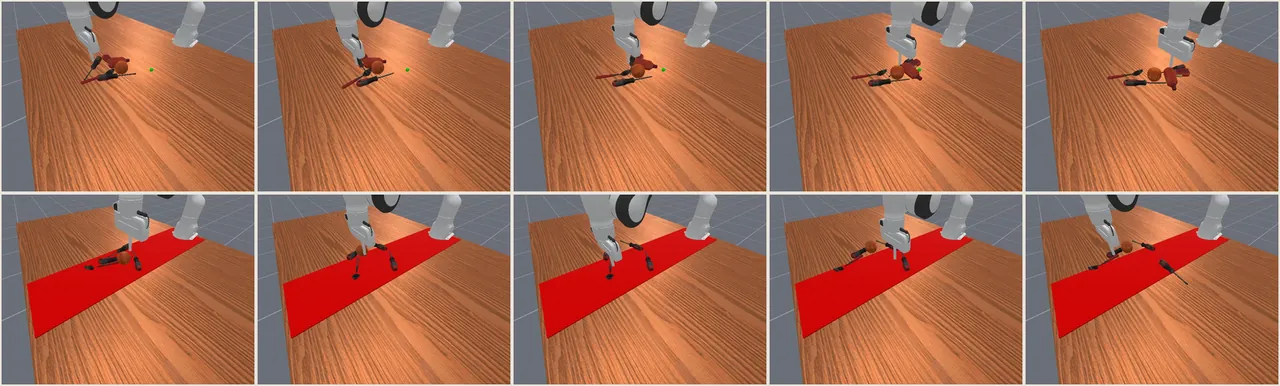
MPC 执行示例:上排 push object to position,下排 clear middle
原文 Fig. 4:5 物体、初始目标值最大的成功 episode。上排 task 1 —— 目标螺丝刀被成功推到绿点标记的目标位置。下排 task 2 —— 红色区域为需清空的中央条带,机器人先把若干物体聚拢再一并推出。

失败模式(作者对 5 物体失败 episode 的目视检查,单个训练种子):(1) 物体被推到接近或超出机械臂运动学工作空间时,机器人会卡住,在 task 2 的多个 episode 中出现;(2) 对螺丝刀、勺子这类细长物体操作吃力,作者认为这暗示“difficulty to accurately predict the movement of such elongated objects”;(3) task 2 中机器人有时在不同目标物体之间反复切换,最终超时——作者认为可通过更精细的规划 cost 设计缓解。

04 Limitations

Note: 前三条是作者在 “Conclusion and Limitations” 一节中明确写出的(stated);后两条来自实验章节中作者自己陈述的事实,标注为 stated(实验章节)。本页没有加入任何作者未提及的推测性局限。
1 · 假设物体掩码与位姿已知,因而只能在合成数据上评测 — stated

原文:“Limitations of the proposed approach are the assumption that object masks and pose estimates of the objects in the scene are known, which restricts the evaluation to synthetic datasets.” 实验中分割掩码与物体/末端执行器位姿全部取自仿真器 ground truth。作者在 Method 中也写明“We leave integrating object segmentation and pose estimation with our dynamics modeling approach to future work”,并提出未来可接入 segmentation foundation models 与 pose trackers 来缓解。

2 · 只建模刚体动力学 — stated

原文:“We further only consider rigid-body dynamics which could be extended in future work by predicting object deformations, too.” 模型的预测目标本身就是每个物体的 SE(3) 相对位姿变化,形变不在表示能力之内。

3 · 尚不适合实时控制 — stated

原文:“Improving the model or planning method for real-time control is also an avenue for future work.” 相关数字:推理时一个 batch(30) 平均需 0.65 s;规划频率被设在 2 Hz,且因为“model rollouts are compute intensive”,每次规划只做一次优化迭代。

4 · 缺少与外部方法的直接对比 — stated(实验章节)

作者说明在“multi-object dynamics with partial observations”这一设定下没有可直接比较的工作:CompNeRFDyn 设定最接近但无代码可用,Neural Gaussian Force Fields 不支持以末端执行器位置动作为条件。因此 Table 1 全部是自身变体/ablation 的横向对比,读者无法据此判断相对于其它 world model 的位置。

5 · 已观察到的具体失败模式 — stated(实验章节)

作者目视检查失败 episode 后列出:机器人在物体被推至运动学工作空间边界附近时卡住;对细长物体(螺丝刀、勺子)的运动预测与操作困难;task 2 中在多个目标物体间反复切换直至超时。此外定性分析指出,接触点靠近质心时旋转容易被低估,而多物体接触下末端执行器的微小偏差会造成物体运动的巨大差异。