ROBOTICS · WORLD MODEL

τ₀-WM: A Unified Video-Action World Model for Robotic Manipulation

先想象、再评估、后执行——把 video prediction 变成机器人可用的动作接口
Pengfei Zhou*, Shengcong Chen*, Di Chen, Jiaxu Wang, Rongjun Jin, Bingwen Zhu, Yike Pan, Songen Gu, Kuanning Wang, Shufeng Nan, Xingyu Qiu, Chenhao Qiu, Pu Yang, Yunuo Cai, Jianxiong Gao, Yifan Li, Yanwei Fu, Xiangyu Yue, Zhi Chen, Jianlan Luo† · Shanghai Innovation Institute / AGIBOT Finch

机器人操作需要的模型不只要能生成可执行动作,还要在真正动手之前预判并评估这些动作的后果。τ₀-WM 把 policy learning、video prediction 和 action evaluation 收进同一个 future-predictive 框架:共享一套 video diffusion 主干,对外暴露两个互补接口——VAM 回答「机器人该做什么」,ACVS 回答「如果这么做会发生什么」。模型在约 27,300 小时异构数据上训练,部署时再用 test-time computation 采样候选、排序、并对低质量候选做 simulator 修正。

arXiv 2606.01027 · cs.RO 5.5B 参数(5B video DiT + 0.5B action DiT) backbone: Wan2.2-TI2V-5B 📄 arXiv:2606.01027 🔗 Project page
world modelvideo-action model机器人操作video diffusionflow matchingtest-time computationaction-conditioned simulationdense reward异构数据预训练cross-embodiment

01 Motivation

论文的出发点是:机器人操作本质上是「在物理后果不确定的情况下行动」。机器人不只要推断哪个动作可能满足语言指令,还要预判这个动作会如何通过 contact、物体运动和多步交互改变场景。而对真实机器人来说,这种预测能力必须与某个具体 embodiment、controller 和 sensing stack 上可执行的动作接口耦合起来。

“Training only on robot demonstrations yields grounded but narrow policies; training only on broad video data yields predictive but action-ungrounded models.”

这就是数据层面的核心矛盾。Egocentric 视频和人类交互轨迹能提供大量关于物体如何运动、contact 如何展开、长程任务如何组织的证据,但它们不包含可部署机器人控制空间里的动作;robot demonstrations 恰好提供这种 grounding,但采集昂贵、覆盖的物体与环境窄得多。所以论文的做法不是二选一,而是把异构性本身当成一种结构化的互补监督:

作者强调,这样学到的表征「不只是 policy learning 的一个 auxiliary feature」,而是一个接口——机器人可以借它提出动作、想象后果、并在执行前修正。

τ₀-WM 总览
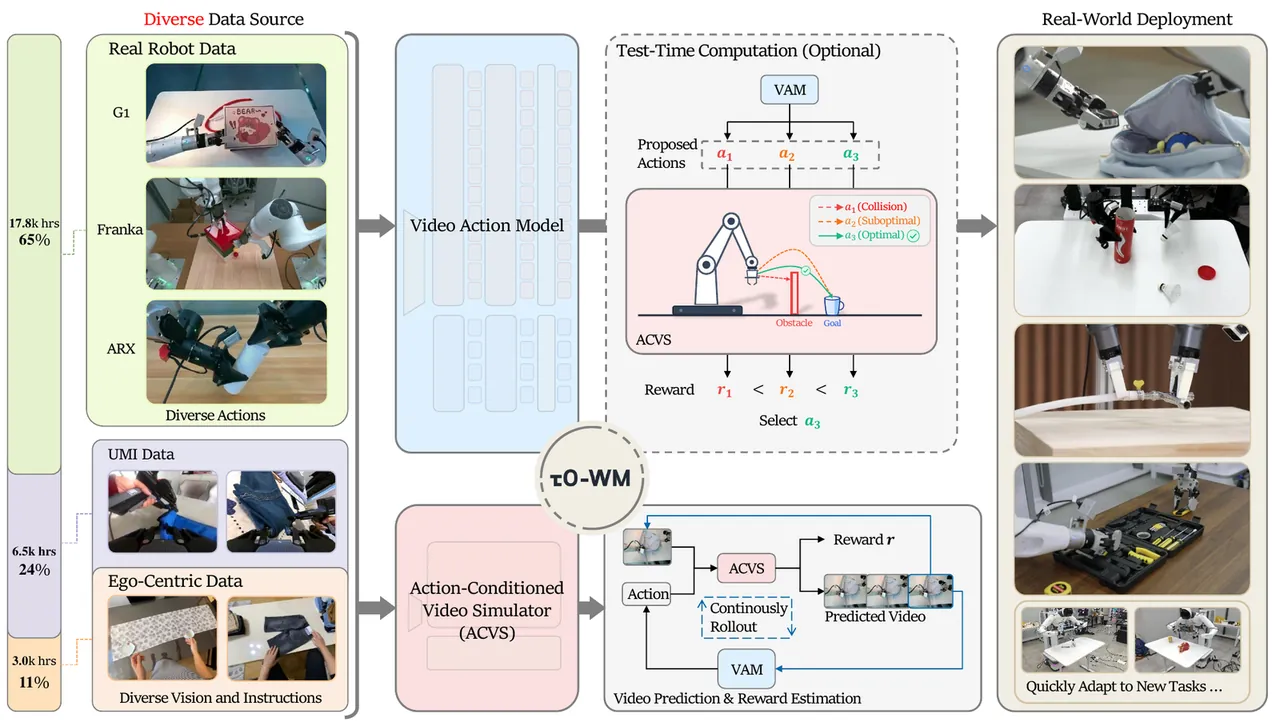
Fig. 1 · τ₀-WM 框架总览。 来自真实机器人、UMI-style 采集和 egocentric 人类视频的异构交互数据,被用来训练 Video Action Model 与 Action-Conditioned Video Simulator。部署时系统提出候选动作,经由 test-time computation 与 simulator-based scoring 评估想象出的未来,再选择或修正动作。左侧柱状条给出数据构成:Real Robot Data 17.8k hrs(65%)、UMI Data 6.5k hrs(24%)、Ego-Centric Data 3.0k hrs(11%)。中间粉色框演示 ACVS 如何把三个候选 a₁/a₂/a₃ 分别 rollout 成 Collision / Suboptimal / Optimal 的未来,并按 reward r₁ < r₂ < r₃ 选出 a₃。
27.3K小时异构预训练数据
0.64四任务平均成功率(best)
0.14→0.55zero-shot 平均成功率(加 UMI+Ego)
0.43→0.60TTC 带来的单次执行平均成功率

02 Method

τ₀-WM 不把 policy learning 与 dynamics modeling 分开,而是把两者都建在同一个 video diffusion 主干上,再从这个主干引出两个互补接口。论文写得很直白:“VAM answers what the robot should do, while ACVS estimates what would happen if a proposed action were executed.”

τ₀-WM 架构
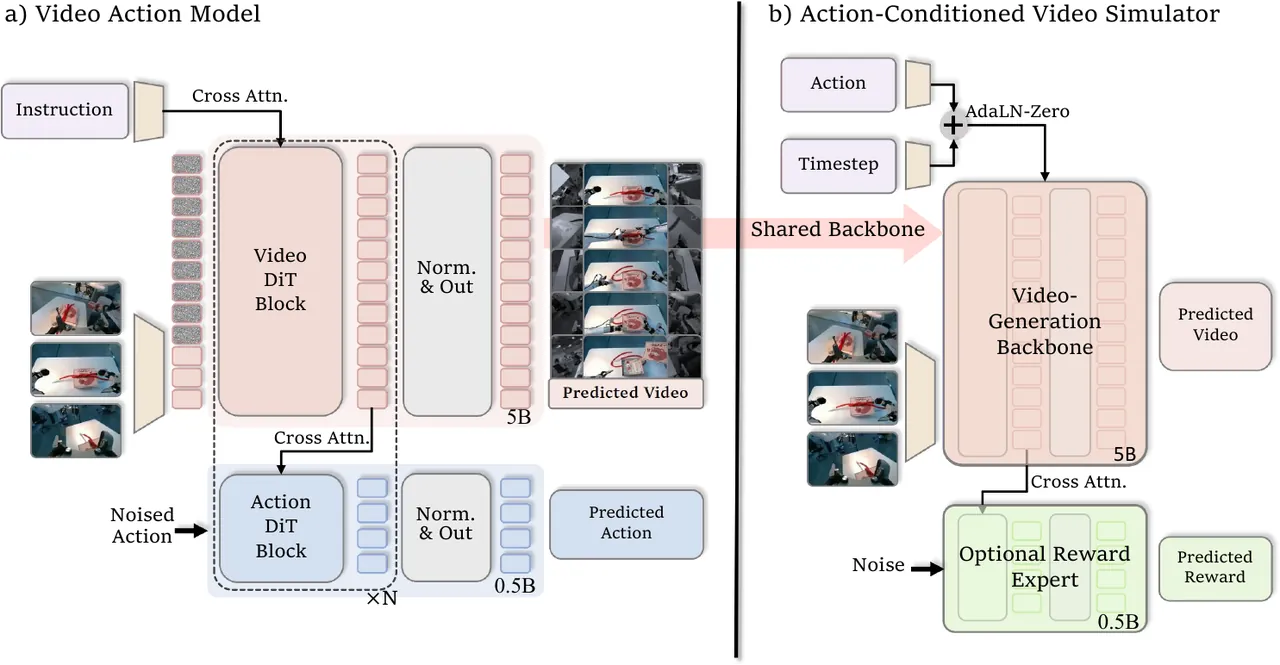
Fig. 2 · τ₀-WM 架构。 (a) VAM 作为 policy 接口,用共享的 video backbone 与一条通过 cross-attention 耦合的 Action DiT 分支,联合预测未来 visual latents 与可执行 action chunk;(b) ACVS 作为评估接口,复用同一 video-generation backbone,把 VAM 提出的 action chunk rollout 成未来视频,并预测 dense reward 分数供 test-time 动作选择使用。注意 (b) 中 Action 与 Timestep 经 MLP 后以 AdaLN-Zero 方式注入主干,Optional Reward Expert(0.5B) 通过 cross-attention 读取 action-conditioned 视频特征。

Video Action Model (VAM) — 策略接口

给定当前多视角观测 ot、语言指令 p 和机器人状态 st,VAM 输出未来视频 latent 轨迹与一段连续 action chunk:Fθ(ot, p, st) → (ẑt+1:t+Hv, ât:t+Ha−1)。

实现上,VAM 由 Wan2.2-TI2V-5B 实例化。Wan VAE 先把每个相机视角编码成 latent tensor;多视角 latent 沿空间宽度维拼接成一张时间对齐的 latent canvas。当前观测 latent 保持 clean 作为 visual context,未来 latent 槽位则被加噪并由 video 分支去噪。video 分支就是原始 Wan video DiT(5B),action 分支是一个 0.5B 的 DiT-style action decoder,合起来构成 5.5B 的 Video Action Model。

两条分支的耦合方式是关键:在对齐的 transformer stage 上,action token 先在 action horizon 内建模时序依赖,然后 cross-attend 到中间的 video features。这些 video feature 同时受 clean visual context 和语言指令约束,于是 action 分支拿到的是「instruction-aware 且 dynamics-relevant」的视觉表征。

Joint Flow-Matching Objective 与监督掩码

VAM 对未来视频 latent 和 action chunk 同时使用 flow matching,损失是两项 vector-field 回归的加权和(论文中一律取 λz = λa = 1)。真正让异构数据能一起训的是 modality-specific supervision masks:robot trajectories 同时贡献视觉预测与动作监督,而 egocentric 人类视频只贡献视觉动力学项、被排除在 action loss 之外。每个样本的 mask 规定了「哪些输入可观测、哪些目标要预测、哪些 loss 被激活」。

Action-Conditioned Video Simulator (ACVS) — 评估接口

ACVS 复用 Wan VAE 与 video transformer,但去掉了 Action DiT policy 分支——它不生成动作,只估计场景在给定动作下会如何演化。给定 memory 观测 ot−M:t、指令 p 和候选 action chunk ā,它输出想象的未来 latent rollout 与 dense reward 轨迹。动作条件的注入沿用 Cosmos 的设计:每个未来 latent 槽位 ℓ 把时间对齐的动作聚成 action block bℓ,经两个轻量 MLP 映射为 caℓ = ψD(bℓ) 与 maℓ = ψ6D(bℓ),分别注入 diffusion-time embedding 与 AdaLN modulation embedding,再沿空间 token 与相机视角广播;观测槽位保持无条件。

Reward 怎么来的:把每个任务分解成 subtask 并在 subtask 级别标注 progress,再用 Monte Carlo propagation 在段内推出 frame-level reward,得到 dense 监督而非单一的终局成功标签。失败数据是刻意被纳入的——失败的 subtask 段整段赋负 reward,教会 ACVS 识别那些通往错误 contact、错误物体运动或任务回退的未来。作者还特意用 failure-heavy 与 recovery 轨迹增强 simulator 训练:这类数据作为 policy 监督可能是次优的,但对 simulator 特别有价值,因为它暴露了 off-distribution 动作与失败交互。

Test-Time Computation:RCS → LAR 的 coarse-to-fine 流程

在大规模异构数据上预训练会让条件动作分布天然 multimodal:同一指令同一场景可以有多条可行动作序列,而它们在精度、鲁棒性和成功率上并不等价。τ₀-WM 因此采用 coarse-to-fine 策略——先用轻量筛选,只有在候选看起来不可靠时才调用昂贵的 rollout 评估。

① Re-denoising Consistency Score (RCS)

VAM 采样 N 个候选 action chunk。对每个候选,随机抽 K 个 flow timestep,按训练时同样的 flow-matching 过程重新加噪,再用 VAM 的 action vector field 评估,得到平均 re-denoising error ERCS。定义 SRCS = −ERCS,取 argmax。RCS 是一个轻量的分布式过滤器:它偏好更贴近已学到的 conditional action manifold 的候选,相比 rollout 评估几乎不增加开销,但也不直接度量任务进展。

② Low-quality Action Rectification (LAR)

当 SRCS(i*) < γ(γ 为可靠性阈值)时——即最自洽的候选也可能很差——才触发 LAR:ACVS 对所有候选预测 rollout 与 dense reward,rollout value 取 J(i) = max0≤q<Ha r̂(i)t+q,即想象 rollout 达到的最大任务进展。关键一步是:并不直接执行最高分候选,而是把选中的 rollout latent ẑ(j*) 转成一个 future condition 注入 VAM,做第二次 policy query,生成一段显式朝该高价值未来引导的精修 action chunk。

默认设置下 TTC 每个决策步用 4 个 action proposals。

03 Experiments

实验横跨三种 embodiment——AGIBOT-G01、ARX manipulators、dual-arm Franka——任务是 language-conditioned、多视角的 packing 与 assembly。主指标是 task success rate。baseline 为 π₀.₅ 与 Fast-WAM;在部署期推理方面,还比较了 standard execution、CFG(classifier-free guidance)与 ACG(Action Coherence Guidance)。

训练分两阶段:pre-training 用 27.3K 小时异构数据,post-training 适配下游任务;global batch size 分别为 12,288 与 384,两阶段均用 AdamW、学习率 5×10⁻⁵。部署时动作以 receding-horizon 闭环执行,action chunk 固定长度 30;单张 RTX 5090 上端到端动作生成延迟约 220 ms/次,缓存可复用的文本表征后可降到约 180 ms(不改变模型输出),再叠加 torch.compile 可进一步降到约 140 ms——但论文正文所有结果都是不开 torch.compile 跑的,以保证一致性与可复现性。

四个评测任务
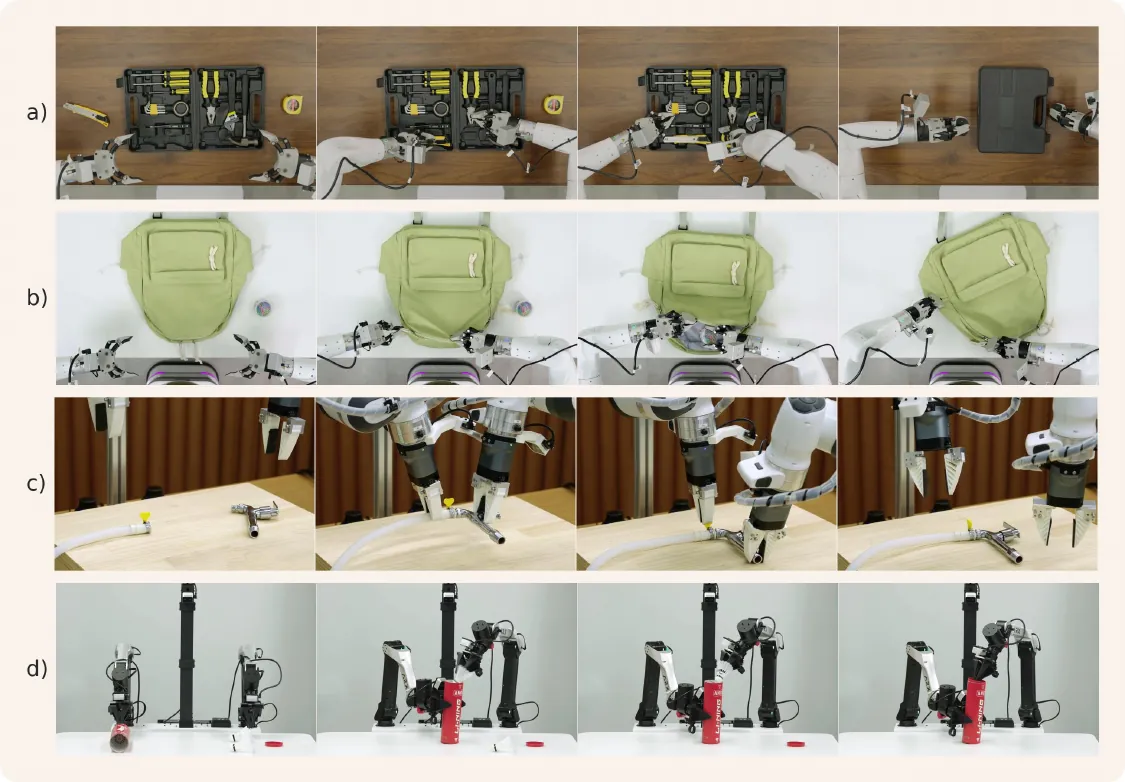
Fig. 3 · 四个评测任务。 (a) 把桌上的不同工具收纳进工具箱对应位置(Toolbox);(b) 拉开书包拉链、把物品放进去、再拉上(School Bag);(c) 把水管接到水龙头上并固定(Faucet);(d) 收纳羽毛球并盖上盖子(Badminton)。四个任务都不在预训练语料中。为评估 embodiment 多样性,Badminton 在 ARX manipulator 上进行、Faucet 在 dual-arm Franka 上进行,其余在 AGIBOT-G01 上。

主结果

主结果对比
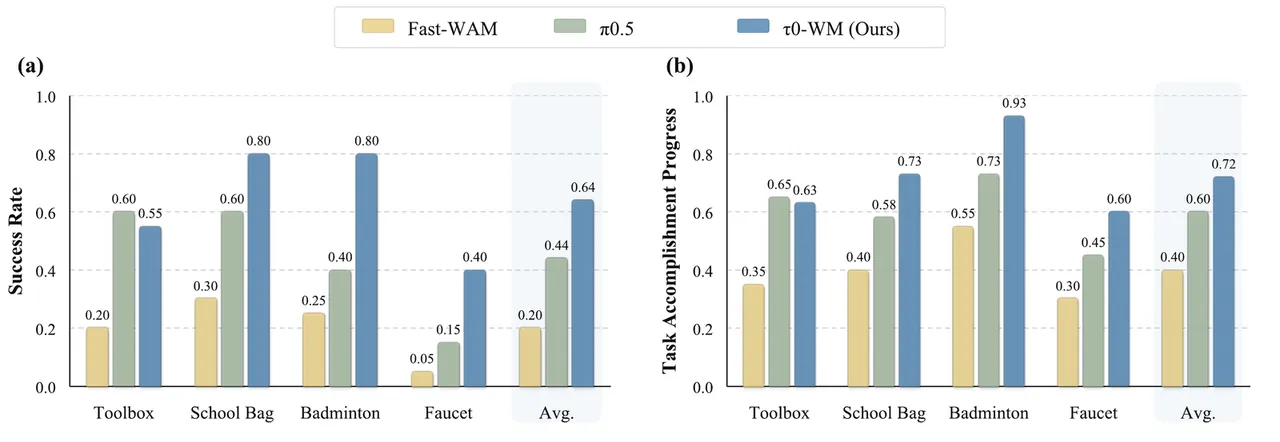
Fig. 4 · 不同模型在成功率与任务完成进度上的对比。 考虑到长程任务的复杂性,作者同时用 task success rate 与 stepwise task accomplishment progress 两个指标评估。
Task Success RateFast-WAMπ₀.₅τ₀-WM (Ours)
Toolbox0.200.600.55
School Bag0.300.600.80
Badminton0.250.400.80
Faucet0.050.150.40
Avg.0.200.440.64
Task Accomplishment ProgressFast-WAMπ₀.₅τ₀-WM (Ours)
Toolbox0.350.650.63
School Bag0.400.580.73
Badminton0.550.730.93
Faucet0.300.450.60
Avg.0.400.600.72
不回避的地方:π₀.₅ 在 Toolbox 上反超 τ₀-WM——success rate 0.60 vs 0.55、progress 0.65 vs 0.63。论文对此的说法是 π₀.₅ “performs competitively on Toolbox”,但在需要更长程协调与更精细操作的任务上性能下降。另外 Faucet 对所有方法都很难(最好也只有 0.40),作者明确承认这个任务 “remains challenging for every method, indicating that the task is far from saturated”。
一个不被二值成功率捕捉到的定性差异值得记:在 Toolbox 中,baseline policy 经常在工具插入正确槽位后就停手,哪怕插入并不到位、工具仍然松动;而 τ₀-WM 常会在结束前补做纠正动作(继续推、压紧工具)。作者的假设是,这来自对未来视觉结果的显式建模,促使 policy 去优化最终场景配置的质量,而不只是抵达一个中间的任务完成状态。

Ablations

① 预训练数据构成。 对比只用 robot teleoperation 数据训练的模型与用完整语料训练的模型。zero-shot 任务是「拿起笔放进笔筒」,SFT 任务是「拿起物体、擦掉污渍、放回桌面」,都在 clean 与 cluttered 两种桌面变体下评估。

DataCleanClut.Avg.
Zero-shot: Pen-to-holder — Robot0.220.060.14
Zero-shot: Pen-to-holder — Robot+UMI+Ego0.560.530.55
SFT: Object-wipe-place — Robot0.850.550.70
SFT: Object-wipe-place — Robot+UMI+Ego0.900.750.83

增益在 zero-shot 设定下最显著(平均 0.14 → 0.55),说明 UMI 与 egocentric 数据主要改善的是通用操作先验与视觉理解,能有效迁移到未见任务;SFT 之后收益依然可见、尤其在 cluttered 条件下,作者据此认为这体现的是鲁棒性提升而非仅仅「适配得更快」。

② Test-time computation。 在两个基于预训练 VAM 的任务上消融:Tissue→Box(抽出纸巾放入盒中)与 Pen→Box(拿起笔放入盒中)。为隔离 TTC 的作用,采用更严格的协议:只允许单次尝试、不允许重试,每个实验重复 20 次。

VariantTissue→BoxPen→BoxAvg.
w/o TTC0.550.300.43
w. CFG0.250.150.20
w. ACG0.400.350.38
w. RCS0.650.350.50
w. RCS + LAR0.700.500.60

两个阶段各自都有增益:只用轻量的 RCS 就把平均成功率从 0.43 提到 0.50,作者由此推断「相当一部分失败源于选到了次优的动作样本,而非 policy 能力不足」;再启用 LAR、借助 action-conditioned 未来 rollout 做修正,平均成功率进一步到 0.60。

值得注意的是,两种既有的 generation-time guidance 方法在这里都不如不用 TTC:CFG 平均 0.20、ACG 平均 0.38,都低于 w/o TTC 的 0.43。论文的解释是 CFG 与 ACG 修改的是生成过程本身,而本文的做法是在执行前显式评估候选动作及其诱导的未来。Pen→Box 上更大的提升进一步说明,future-conditioned rectification 对需要精确放置与对齐的任务尤其有益。

04 Limitations

Note: 这篇论文没有独立的 Limitations 章节。以下第 1–3 条来自作者在 “Conclusion and Future Work” 中明确陈述的不足与待解问题(标注为 stated);第 4–5 条是从方法设计与实验设置推断的(标注为 inferred),并非论文原文主张。
1 · 只靠视觉不足以支撑 contact-rich 的灵巧操作 (stated)

作者写道:“many dexterous manipulation tasks require information beyond vision alone.” 他们认为引入额外的感知模态、尤其是 tactile feedback,才可能更可靠地建模 insertion、fastening 与可形变物体操作这类 contact-rich 交互。当前 τ₀-WM 的想象与评分完全建立在视觉未来之上。

2 · 部署期推理机制仍不够可靠 (stated)

尽管 TTC 已经改善了执行表现,作者仍把「developing more reliable deployment-time reasoning mechanisms」列为 an important challenge,并点名三个方向:更好的 uncertainty estimation、更长程的评估、以及更有效的 search 策略,用以改善困难状态下的动作选择。这也呼应了 RCS 本身的性质——它只是分布上的自洽性过滤,并不直接度量任务进展。

3 · 预测时域与场景复杂度仍然有限 (stated)

作者认为把 predictive modeling 扩展到「longer temporal horizons and more complex manipulation scenarios」才可能带来更丰富的 future imagination 与更强的决策能力,暗示当前 rollout 的时间跨度与任务复杂度都还受限。

4 · 评测规模偏小,且并非在所有任务上领先 (inferred)

主结果只覆盖 4 个任务、baseline 只有 π₀.₅ 与 Fast-WAM 两个;TTC 消融只有 2 个任务、每个重复 20 次。在这种样本量下,0.05 量级的差异(如 Toolbox 上 0.60 vs 0.55)很难说是稳定结论。而且 π₀.₅ 在 Toolbox 上确实两个指标都略优于 τ₀-WM,Faucet 的最好成绩也只有 0.40。

5 · LAR 的额外开销与触发阈值未被量化 (inferred)

论文给出了标准部署下约 220/180/140 ms 的动作生成延迟,但这是 action-only 路径的数字;一旦触发 LAR,需要对全部 N 个候选跑 ACVS 的视频 rollout、再做第二次 VAM query,其真实延迟与触发频率论文中没有给出。可靠性阈值 γ 的取值、以及它如何权衡实时性与成功率,也未见报告。