"However, while the physical world is three-dimensional in nature, existing world models operate in the space of 2D pixels. This limitation leads to an incomplete representation of spatial relationships, impeding tasks that require precise depth and pose information."
直接学 4D 世界又太贵:模型要同时在三维空间和时间上产生输出,训练开销极高。作者的取舍是找一个更轻量的 4D 表征——预测一串 RGB、depth、normal 图。它既能刻画外观、几何与表面,维度又远低于显式预测世界动力学;而且这种表征与现有 video model 高度同构,可以直接借用视频生成模型的生成能力来 bootstrap 4D 世界模型。
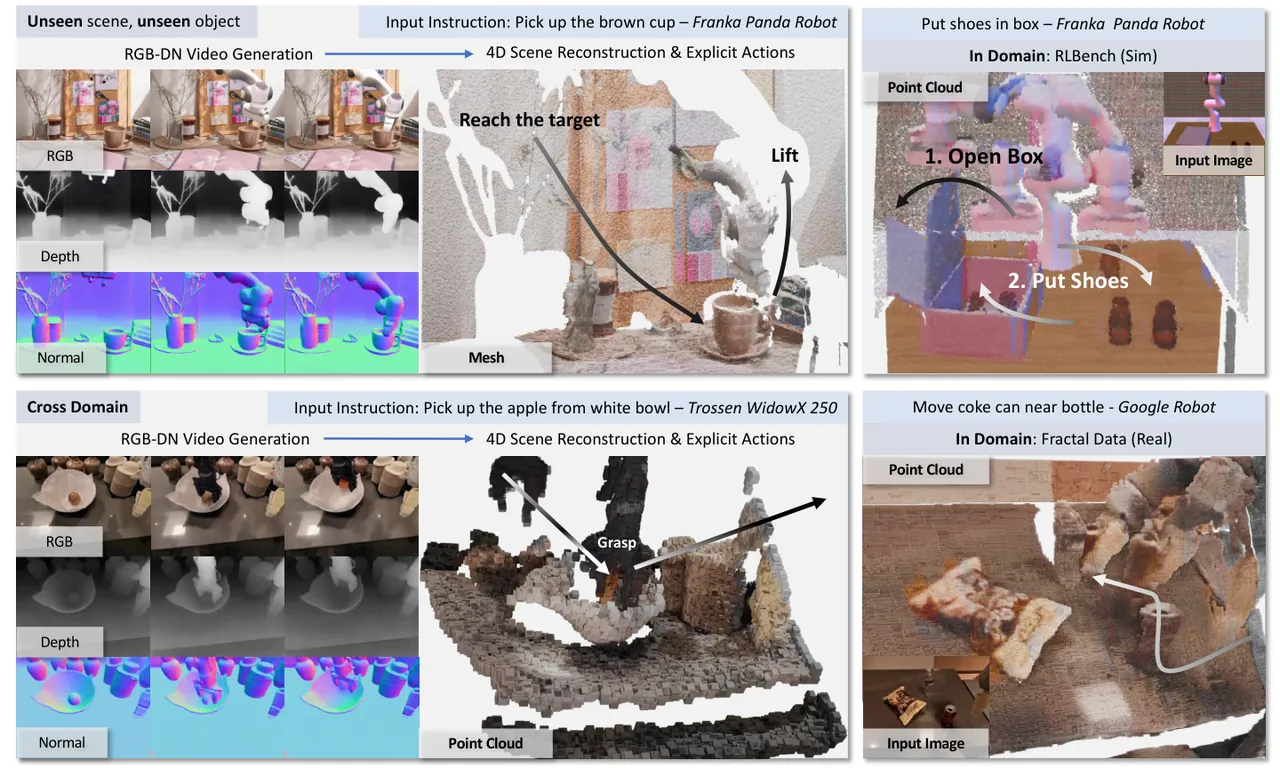
Figure 1. TesserAct 接收一张输入图像与一条文本指令,生成 RGB、depth、normal 三路视频,进而重建 4D 场景并预测动作。论文称其"not only achieves strong performance on in-domain",同时也能泛化到未见场景与物体。
0.0811Chamfer L1(RLBench 合成域,全场最优)
~200k自建 4D embodied 视频数据总量
7 / 9RLBench 任务成功率超过 UniPi*
~1 min新视角合成耗时(SoM 需 ~2 hours)
02 Method
整条链路分三步:(1) 自动构建 4D embodied video dataset;(2) 改造并微调 CogVideoX,把它变成条件式 RGB-DN 联合生成器;(3) 用 normal integration + 两个新损失,把生成的 RGB-DN 视频优化成时空一致的 4D 点云;最后 (4) 在 4D 点云上训练 inverse dynamics model 输出动作。
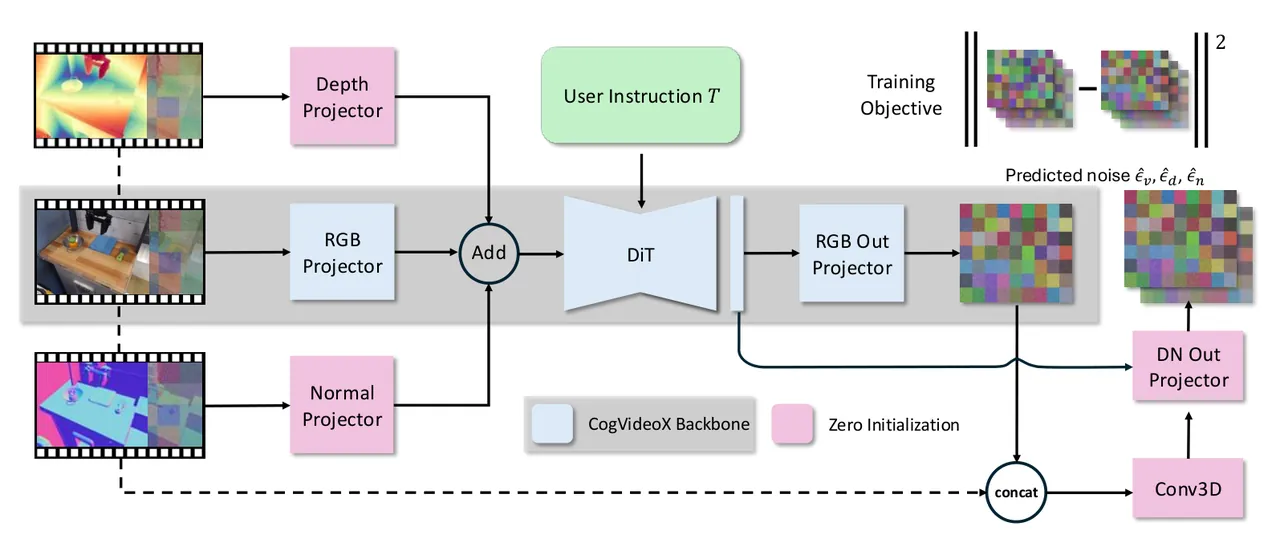
Figure 2. TesserAct 的架构与训练总览。CogVideoX 的 3D VAE 分别编码 RGB / depth / normal 三路视频(VAE 本身不再微调),加噪得到 xt,与首帧 latent x0 一起经三个独立的 InputProj 得到 embedding;DiT 取三者之和作输入,条件是文本 𝒯 与去噪步 t。RGB 分支保留原输出头;depth / normal 另加一路 Conv3D,把「输入 latent + 已去噪的 RGB 输出」拼接编码后与 DiT hidden state 融合,再过 DNProj 得到 depth/normal 的去噪预测。
1) 4D embodied video dataset:合成给 GT,真实靠估计器
合成域取 RLBench 中 20 个相对高难度的任务,每个任务从 4 个视角生成 1000 个 instance,共 80k 条合成 4D 视频;仿真器只给 metric depth,法向用 DSINE 的 depth2normal 补出;并借 Colosseum 的 scene randomization 改变背景、桌面纹理与光照以增强泛化。真实域用 RollingDepth 标注 affine-invariant depth,法向用 Temporal-Consistent Marigold-LCM-normal(论文明确指出"a reliable video normal estimator is currently unavailable")。
Dataset
Domain
Depth Source
Normal Source
Embodiment
# videos
RLBench
Synthetic
Simulator
Depth2Normal
Franka Panda
80k
RT1 Fractal Data
Real
Rolling Depth
Marigold
Google Robot
80k
Bridge
Real
Rolling Depth
Marigold
WidowX
25k
SomethingSomethingV2
Real
Rolling Depth
Marigold
Human Hand
100k
数据量的现实:论文自己承认这套数据"comprises only about 200k data points, which is insufficient to train a world model from scratch"——所以必须从 CogVideoX 权重初始化,其余新模块全部零初始化,保证训练之初 RGB 输出与原始 CogVideoX 完全一致,把预训练知识原样保留下来。
2) RGB-DN 联合生成:一次 forward 出三种模态
任务被形式化为条件去噪生成 p(v,d,n | v0,d0,n0, 𝒯):给定首帧的 RGB / depth / normal latent 与文本动作指令,预测未来的三路 latent 序列。为区分不同机械臂,文本被构造成 [action instruction] + [robot arm name],例如 "pick up apple google robot"。训练目标就是标准的 ε-prediction MSE,只不过噪声是 [εv, εd, εn] 三者拼接。训练采用 multi-resolution 策略,一次预测 49 帧。
3) 4D 场景重建:法向积分 + 一致性/正则损失
生成的 depth 是 [0,1] 的相对图,无法直接重建整个场景;以往要么假设一个默认 scale,要么直接预测 metric depth,结果"often coarse and often cause reconstructed planes or walls to be tilted"。TesserAct 改用 normal integration(沿用 Bilateral Normal Integration 的迭代加权最小二乘)在空间上把 normal 的表面朝向约束灌进 depth,得到损失项 𝓛s。
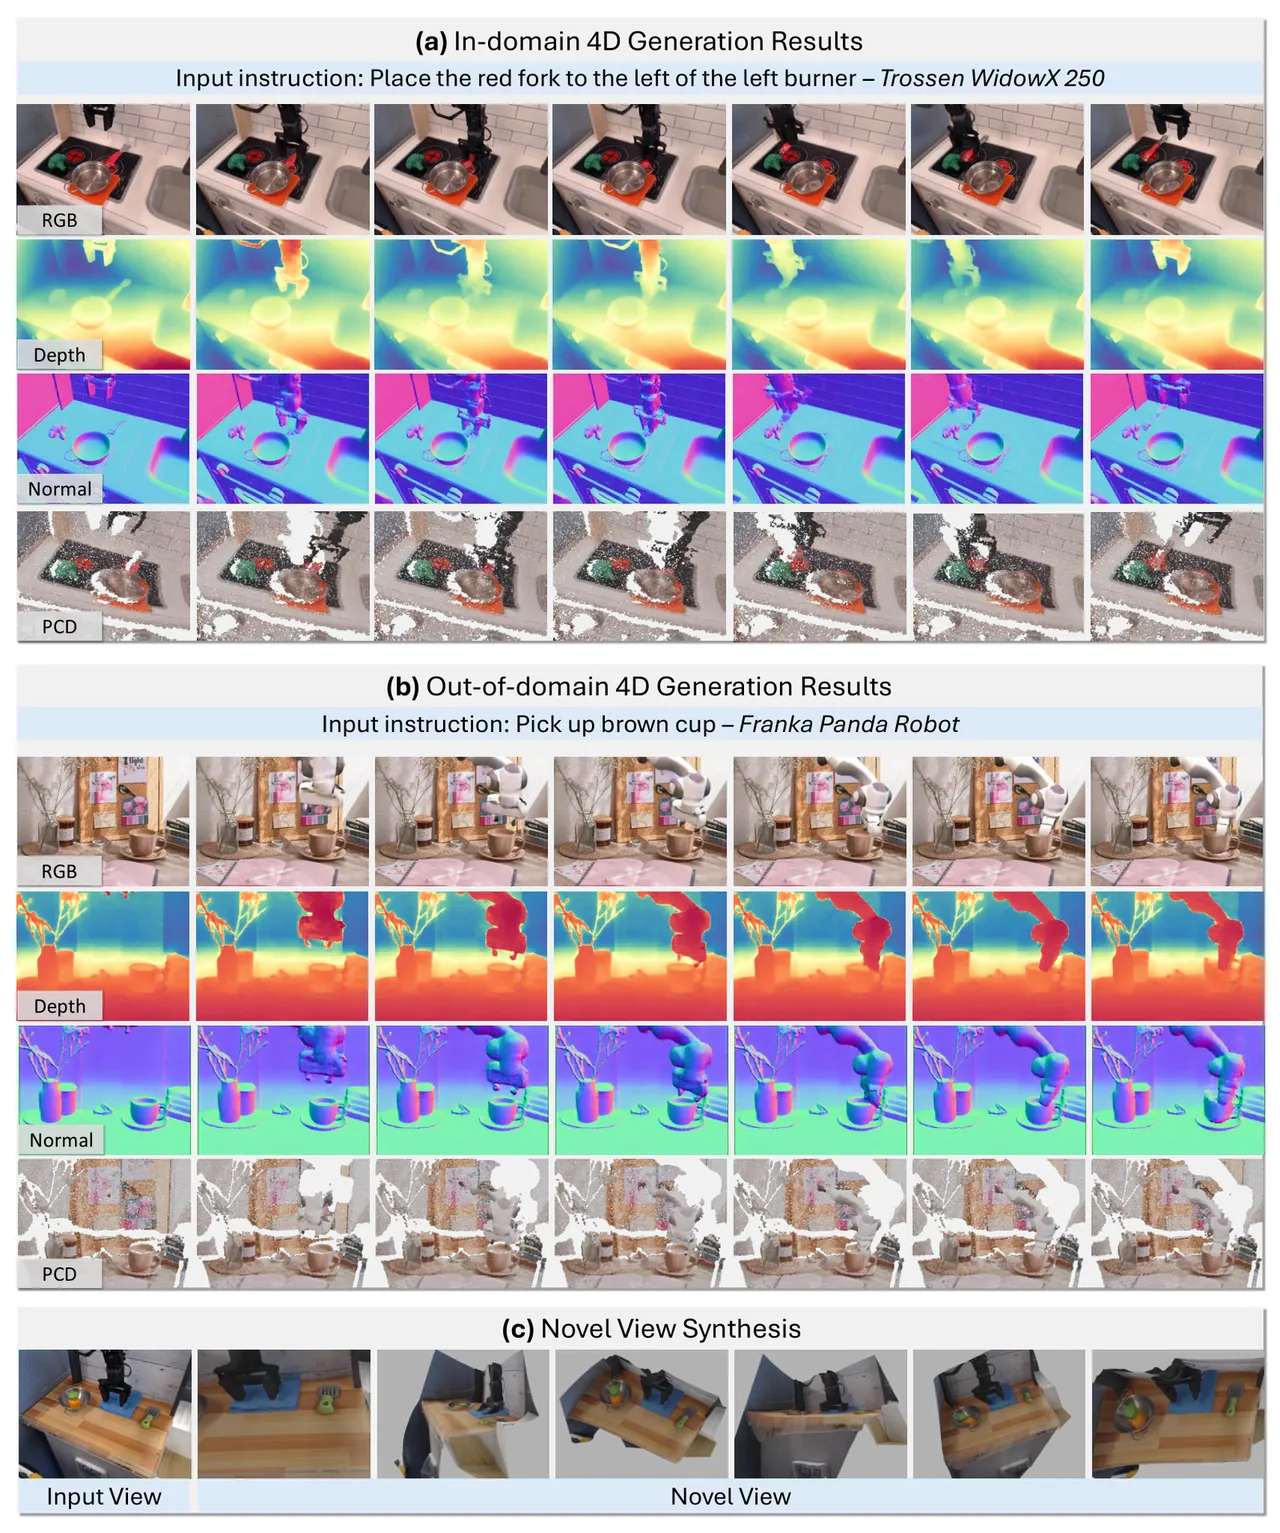
不回避的败绩:在 Real 域,CogVideoX 的 RGB 三项全面领先(FVD 20.64 vs 21.59、SSIM 79.38 vs 75.86、PSNR 22.39 vs 20.27);合成域的 PSNR 也是 CogVideoX 更高(20.87 vs 19.73),法向 Mean 则是 OpenSora 更低(12.94 vs 14.75)。TesserAct 的优势集中在几何——深度(AbsRel / δ₁ / δ₂)、法向 Median 与 11.25°,以及最终的 Chamfer L1,论文的措辞是"predicts the depth and normal maps most accurately without hurting"(RGB 质量)。合成域的 Chamfer L1 从次优的 0.1086(4D Point-E)降到 0.0811,是最大的一档提升。
"However, in the open microwave and weighing off tasks, the performance is not as good as the baseline, possibly because these tasks already have sufficient information in the 2D front image."
Table 4 · RLBench 新视角合成:快了两个数量级
输入单目前置相机视频,在 overhead 与 left shoulder 相机上评估,对手是基于 Gaussian splatting 的 SOTA 视频重建方法 Shape of Motion (SoM)。
Method
PSNR ↑
SSIM ↑
LPIPS ↓
CLIP Score ↑
CLIP Aesthetic ↑
Time Costs
SoM
10.94
24.02
73.82
66.67
3.61
~2 hours
Ours
12.99
42.62
60.51
83.02
3.73
~1 mins
Ablations · 一致性与正则损失确实有用
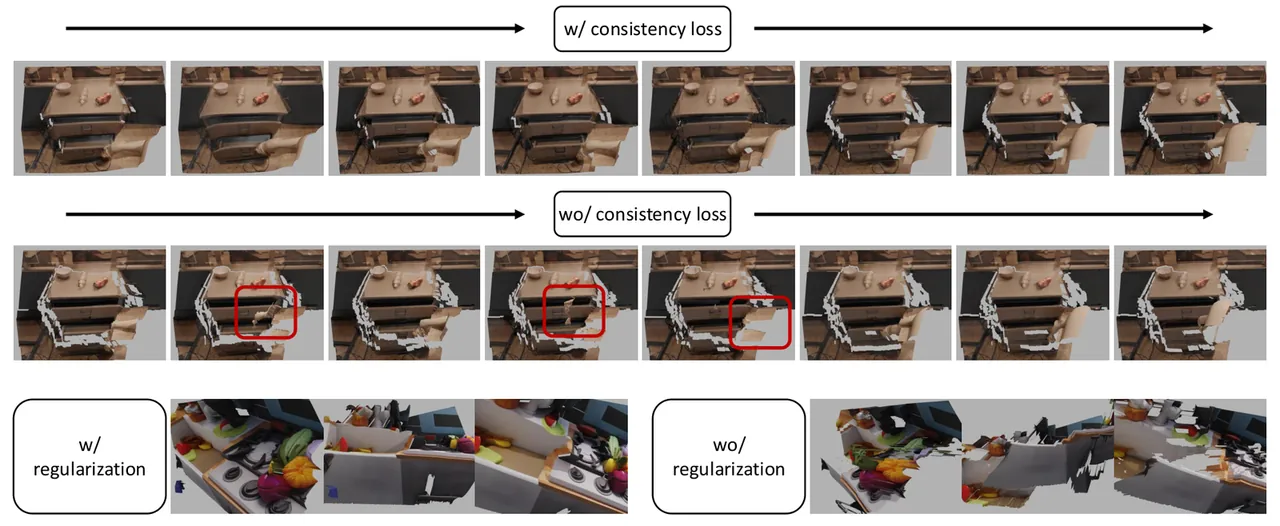
Figure 3. 一致性损失与正则损失对 4D 场景重建的影响,红框标出不一致的区域。前两行是同一相机视角、不同时间步的渲染:加上 consistency loss 后机械臂的运动明显更连贯;最后一行是同一帧的三个不同视角,说明 regularization loss 有助于提升重建的几何准确性。
论文原文:"While our RGB-DN representation of a 4D world model is cheap and easy to predict, it only captures a single surface of the world. To construct a more complete 4D world model, it may be interesting in the future to have a generative model that generates multiple RGB-DN views of the world, which can then be integrated to form a more complete 4D world model." 换言之,遮挡背面、物体内部都不在这套表征里,多视角 RGB-DN 生成再融合是作者点名的后续方向。
2. 真实域的「真值」本身是估计出来的(inferred)
RT1 / Bridge / SSv2 的 depth 来自 RollingDepth、normal 来自 Marigold-LCM,训练与评测用的都是同一批估计标注(论文在 §5.1.1 明确说真实域样本的 depth 和 normal "are estimated as in Sec. 4.1")。因此 Real 域的几何指标衡量的是与估计器的一致程度,而非与物理真值的一致程度;论文自己也指出目前缺少可靠的 video normal estimator。